


AI ถอดเสียงกำลังขยับจากการ “รอฟังให้จบแล้วค่อยพิมพ์” ไปอีกขั้น เพราะ Microsoft เปิดตัว MAI-Transcribe-2-Streaming โมเดล AI สำหรับแปลงเสียงเป็นข้อความแบบเรียลไทม์ ที่สามารถเริ่มสร้างข้อความระหว่างที่ผู้ใช้กำลังพูดได้ โดยรองรับมากถึง 60 ภาษา
จุดเด่นของโมเดลนี้คือ
ระบบไม่จำเป็นต้องรอให้ประโยคจบก่อนถึงจะเริ่มประมวลผล แต่สามารถปล่อยข้อความบางส่วน หรือ Partial Transcript ออกมาก่อนได้ หลังได้รับเสียงเพียง 100 กว่ามิลลิวินาที จากนั้น AI จะค่อย ๆ ปรับข้อความตามบริบทใหม่ที่เข้ามา ก่อนยืนยันเป็นข้อความฉบับสุดท้ายเมื่อจับได้ว่าผู้พูดหยุดพูด
ด้านความแม่นยำ MAI-Transcribe-2-Streaming ก็ทำผลงานได้โดดเด่น โดยผลทดสอบล่าสุดจาก Artificial Analysis จัดให้โมเดลนี้ขึ้นอันดับ 1 ในการทดสอบ AA-WER Streaming ทั้งในส่วนข้อความระหว่างการพูดและข้อความสุดท้าย
สำหรับข้อความฉบับสุดท้าย โมเดลทำค่า Word Error Rate (WER) อยู่ที่ 2.5% โดยสามารถส่ง Final Transcript หลังตรวจพบว่าผู้พูดหยุดประมาณ 0.13 วินาที ค่า WER เป็นตัวชี้วัดความผิดพลาดในการถอดเสียง ยิ่งตัวเลขต่ำก็หมายถึงมีคำที่ถอดผิด หายไป หรือถูกใส่เกินน้อยลง
อย่างไรก็ตาม ตัวเลข WER 2.5% ไม่ได้หมายความว่า
AI จะถอดเสียงได้แม่นยำ 97.5% ในทุกภาษาและทุกสถานการณ์ เพราะผลดังกล่าวมาจากชุดทดสอบของ Artificial Analysis ซึ่งใช้เสียงรวมประมาณ 8 ชั่วโมงจาก 3 ชุดข้อมูล ขณะที่การใช้งานจริงยังขึ้นอยู่กับปัจจัยอย่างภาษา สำเนียง คุณภาพไมโครโฟน เสียงรบกวน และรูปแบบของบทสนทนา
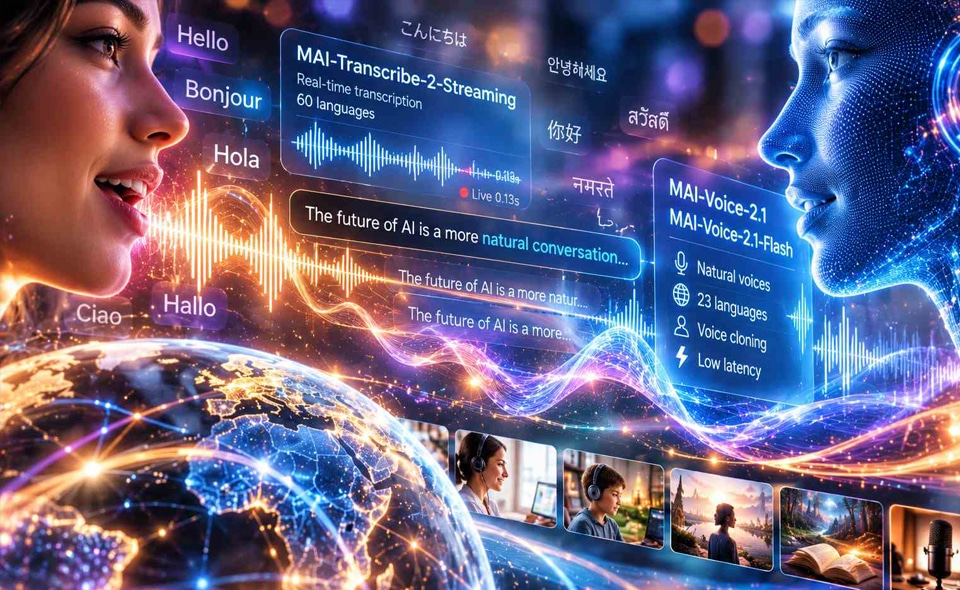
Microsoft มองว่าโมเดลนี้เหมาะกับงานที่ให้ความสำคัญกับความเร็ว เช่น Live Caption, ระบบพิมพ์ตามเสียง, Call Center และ Voice Agent เพราะระบบ AI อื่น ๆ สามารถเริ่มนำข้อความที่กำลังถูกถอดเสียงไปประมวลผลได้ทันที โดยไม่ต้องรอให้ผู้พูดพูดจบทั้งประโยค
ในด้านราคา Microsoft เปิดตัว MAI-Transcribe-2-Streaming อยู่ที่
0.54 ดอลลาร์ต่อเสียง 1 ชั่วโมงจนถึงสิ้นปี 2026 ซึ่งสูงกว่า MAI-Transcribe-2 รุ่นที่ใช้ประมวลผลไฟล์เสียงย้อนหลัง ซึ่งมีราคาโปรโมชันอยู่ที่ 0.10 ดอลลาร์ต่อชั่วโมง โดยส่วนต่างนี้แลกกับความสามารถในการประมวลผลเสียงแบบเรียลไทม์
นอกจากโมเดลสำหรับ “ฟัง” แล้ว Microsoft ยังเปิดตัว MAI-Voice-2.1 และ MAI-Voice-2.1-Flash สำหรับสร้างเสียงพูด รองรับ 23 ภาษา โดยรุ่น Flash ถูกออกแบบมาเน้นงานที่ต้องตอบสนองรวดเร็ว เช่น Voice Assistant และระบบบริการลูกค้า
ปัจจุบันโมเดลชุดใหม่นี้เริ่มนำไปใช้งานผ่าน Microsoft Foundry, MAI Playground, Vercel และ Azure Voice Live สะท้อนทิศทางของ Microsoft ที่กำลังพัฒนาทั้งระบบรับเสียงและสร้างเสียงให้ทำงานร่วมกัน เพื่อให้ Voice Agent สามารถรับฟัง ประมวลผล และตอบกลับได้ใกล้เคียงกับจังหวะการสนทนาของมนุษย์มากขึ้น
tags : microsoft